Une IA peut citer les bonnes pages et parler de la mauvaise entreprise
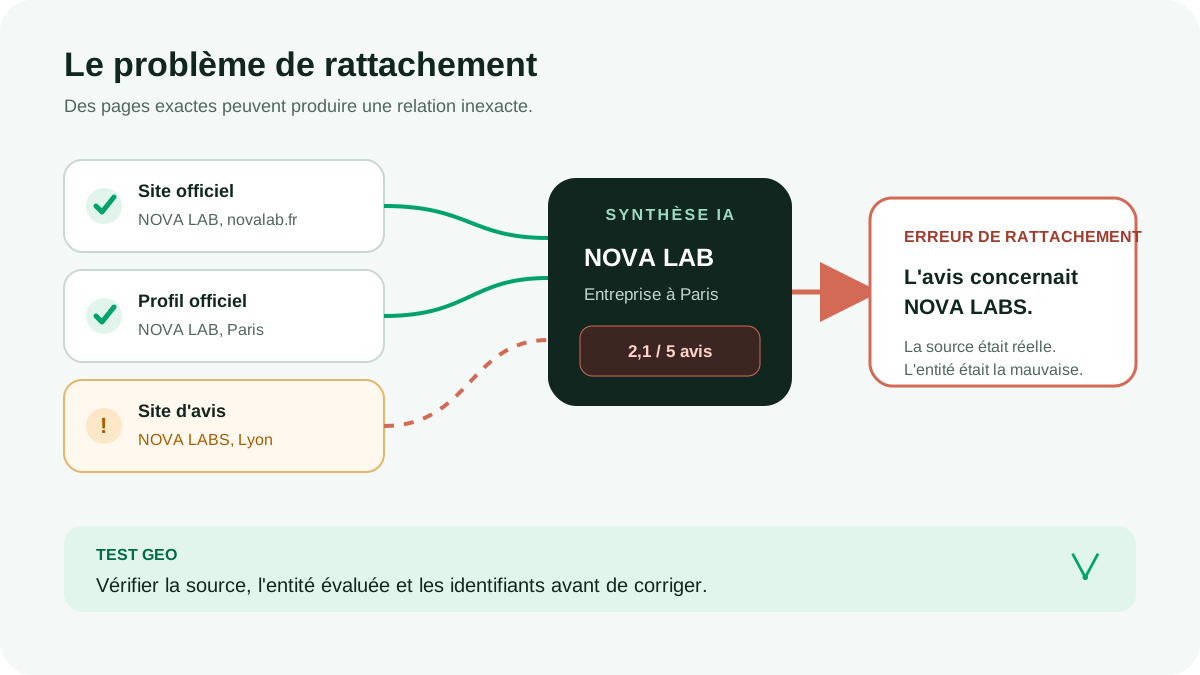
Sur plusieurs sites analysés, nous avons observé le même type de problème : deux noms ou domaines proches apparaissent dans les résultats, puis une réponse rattache un avis, une réputation ou une information à la mauvaise entité.
Nous ne publions pas de taux. L’échantillon n’a pas été construit pour mesurer la fréquence du phénomène et les boutiques concernées ne nous ont pas autorisés à les identifier. L’observation suffit néanmoins à définir un test : une marque n’est pas réellement prête pour les moteurs génératifs si les faits qui la concernent ne peuvent pas être distingués de ceux d’une autre entreprise.
Ce risque ne se réduit pas à une « hallucination ». Une réponse peut citer des pages réelles, pertinentes pour une partie de la question, puis produire une relation qui n’existe dans aucune page prise séparément.
Le 28 mai 2026, un tribunal allemand a documenté précisément ce cas.
Le cas de Munich du 28 mai 2026
Dans l’affaire 26 O 869/26, le Landgericht München I examinait des réponses générées par Google AI Overview à propos de deux sociétés d’édition.
Une requête associant le nom d’une société au terme allemand désignant un procédé frauduleux avait déclenché une réponse affirmative. L’AI Overview décrivait des pratiques commerciales douteuses, des pièges d’abonnement et des liens avec d’autres entreprises.
Le point important pour le GEO se trouve dans le raisonnement du tribunal : certaines relations formulées dans la synthèse ne figuraient pas dans les pages citées. La réponse ne présentait pas simplement une liste de liens. Elle avait organisé plusieurs résultats, relié leurs contenus et produit de nouvelles affirmations.
Le tribunal a ordonné en référé l’arrêt de certaines déclarations et a considéré que Google devait répondre de cette synthèse. Cette décision a toutefois un périmètre précis :
- c’est une décision allemande en référé ;
- elle concerne des affirmations déterminées et un dossier déterminé ;
- elle ne décrit pas l’algorithme interne de Google ;
- elle ne prouve pas qu’un balisage schema.org aurait empêché l’erreur ;
- elle ne transforme pas chaque réponse inexacte en faute juridique identique.
Ce qu’elle établit utilement est plus étroit : une synthèse générative peut créer une association absente des sources qui l’ont alimentée.
Ce qui est établi, et ce qui reste une lecture opérationnelle
Google explique que ses fonctions de recherche générative utilisent notamment le RAG et le query fan-out. Le système peut lancer plusieurs recherches connexes, récupérer des pages dans l’index puis produire une réponse ancrée dans ces résultats.
Google ne publie pas la séquence exacte qui a conduit à l’erreur de Munich. Il serait donc excessif d’affirmer que des noms proches en sont la cause ou que l’ajout de sameAs l’aurait corrigée.
Pour auditer le problème, nous utilisons un modèle en quatre étapes :
- Récupération. Quelles pages et quelles données sont disponibles pour la requête ?
- Résolution d’entité. De quelle entreprise, personne, marque ou référence produit parle chaque source ?
- Rattachement des faits. À quelle entité l’avis, le prix, l’accusation ou la politique est-il associé ?
- Synthèse. La réponse finale conserve-t-elle correctement ces rattachements ?
Ce modèle ne prétend pas reproduire l’architecture de Google, d’OpenAI ou d’un autre moteur. Il permet de localiser une erreur observable sans confondre récupération, interprétation et génération.
Collision numéro 1 : l’identité de l’entreprise
Une entreprise possède souvent plusieurs noms légitimes : raison sociale, nom commercial, nom du site, ancien nom, marque abrégée et domaine. Le problème commence lorsqu’ils sont utilisés sans relation claire ou lorsqu’une autre société occupe un nom presque identique.
Google recommande d’indiquer le nom du site avec un bloc WebSite sur la page d’accueil. Le système considère aussi og:site_name, le titre, les titres de section et les autres textes de la page. Google demande d’utiliser un nom unique, fidèle et cohérent. alternateName permet de proposer de vrais noms alternatifs, pas une liste de mots-clés.
Pour l’entreprise, le balisage Organization ou OnlineStore peut décrire :
| Propriété | Rôle vérifiable |
|---|---|
name | Nom public utilisé par l’entreprise |
alternateName | Autre nom réellement utilisé, si applicable |
legalName | Raison sociale enregistrée si elle diffère du nom public |
url | Site officiel, que Google dit utiliser pour aider à identifier l’organisation |
logo | Logo représentatif et accessible |
sameAs | Profils officiels ou pages tierces qui décrivent la même organisation |
email, telephone, address | Coordonnées applicables et cohérentes |
vatID, taxID, iso6523Code | Identifiants légaux applicables |
Il faut publier uniquement les propriétés vraies et utiles. Ajouter un identifiant inventé ou un profil non contrôlé crée davantage d’ambiguïté.
Le balisage ne remplace pas la cohérence visible. Si le JSON-LD dit « Nova Lab », le titre « Nova Labs France », le compte social « Nova Commerce » et les mentions légales « NL Digital SAS » sans expliquer leurs relations, un parseur reçoit quatre étiquettes et aucune hiérarchie claire.
Collision numéro 2 : l’identité du produit
Une boutique peut être correctement identifiée et laisser ses produits ambigus. C’est fréquent avec les variantes, les produits distribués par plusieurs vendeurs, les marques blanches et les catalogues où le SKU interne remplace un identifiant mondial.
Le contrat d’identité produit comprend au minimum :
- la marque ;
- le GTIN lorsque le produit en possède un ;
- le MPN du fabricant lorsqu’il s’applique ;
- le SKU interne ;
- l’URL canonique ;
- le produit parent et la variante ;
- le vendeur ou fabricant lorsqu’ils sont différents ;
- les mêmes valeurs dans Shopify, la page, les données structurées et les feeds.
Un SKU est généralement propre à une boutique. Il aide à retrouver une ligne dans Shopify, mais ne suffit pas toujours à identifier un produit entre plusieurs marchands. Un GTIN valide joue précisément ce rôle transversal.
Google recommande d’utiliser les données structurées Product et Merchant Center ensemble lorsque cela s’applique. Cette recommandation ne signifie pas que les deux sources sont toujours fusionnées ni qu’une valeur correcte dans l’une corrigera automatiquement l’autre.
Pourquoi les avis sont particulièrement sensibles
Un avis peut porter sur trois objets différents : l’entreprise, le marchand qui a vendu le produit ou le produit lui-même. Afficher cinq étoiles sans préciser l’entité évaluée ne suffit pas.
Google Merchant Center indique que les notes produit peuvent agréger plusieurs sources : marchands, agrégateurs, sites d’avis et utilisateurs Google. La correspondance repose d’abord sur les identifiants produit uniques, notamment le GTIN.
Si le GTIN est absent ou inexact, Google tente des correspondances par SKU, par couple marque plus MPN ou par URL. Google précise que ces solutions de secours entraînent moins d’avis correctement associés. Il ne dit pas qu’elles provoquent nécessairement une attribution à un autre produit. La conclusion correcte est donc : des identifiants incomplets rendent la correspondance moins fiable, pas qu’ils expliquent chaque erreur observée.
Les contrôles sont directs :
- Le GTIN est-il identique dans Shopify, Merchant Center et le feed d’avis ?
- La marque respecte-t-elle la même orthographe partout ?
- Le MPN vient-il du fabricant ou a-t-il été remplacé par un SKU maison ?
- L’avis est-il rattaché au
Product, au marchand ou à l’Organization? - L’URL du produit dans le feed redirige-t-elle vers la bonne page canonique ?
Dans ChatGPT Shopping, OpenAI indique que les résumés d’avis peuvent provenir de sites publics et que les avis et notes ne sont pas vérifiés par OpenAI. Cela justifie une surveillance, pas la promesse qu’un champ Shopify particulier contrôlera la synthèse.
Notre analyse sur les avis clients invisibles pour les moteurs IA traite l’autre moitié du problème : un avis peut être rattaché au bon produit mais absent du HTML servi.
Protocole de test en cinq requêtes
Ne testez pas seulement « que savez-vous de ma marque ? ». Une question vague mélange notoriété, identité, produits et réputation.
Utilisez cinq requêtes séparées :
- Nom exact de la marque. Vérifiez le domaine, l’activité, le pays et la raison sociale proposés.
- Nom de la marque + avis. Relevez si les avis concernent l’entreprise, le marchand ou un produit.
- Nom de la marque + produit prioritaire. Contrôlez la marque, le vendeur, le prix, la variante et les sources.
- Nom de la marque + homonyme connu. Vérifiez si la réponse sépare explicitement les deux entités.
- Nom du produit + marque. Contrôlez si les avis et caractéristiques portent sur la bonne référence.
Pour chaque test, conservez :
| Champ | Pourquoi il compte |
|---|---|
| Date et heure | Les réponses et index évoluent |
| Pays et langue | Les sources récupérées peuvent changer |
| Session connectée ou non | La personnalisation peut influencer la réponse |
| Requête exacte | Une reformulation peut changer le fan-out |
| Réponse complète | Une capture isolée peut retirer une nuance |
| Toutes les URL citées | Il faut vérifier la présence réelle de chaque affirmation |
| Entité attendue | Entreprise, marchand ou produit |
| Verdict | Correct, ambigu, mal rattaché, non vérifiable |
Une seule réponse incorrecte justifie une investigation, pas une conclusion générale sur la plateforme. Rejouez le test dans une nouvelle session et vérifiez chaque source avant de qualifier le problème.
Ordre de correction
1. Déterminer où l’erreur apparaît
La page citée contient-elle réellement l’information ? L’information concerne-t-elle votre entreprise ou un homonyme ? La réponse a-t-elle créé une relation absente de la source ?
2. Stabiliser le nom du site
Alignez WebSite.name, WebSite.url, og:site_name, le titre de la page d’accueil et le nom visible. Ajoutez uniquement les alternateName réellement utilisés.
3. Décrire l’organisation
Utilisez Organization ou OnlineStore avec le nom public, la raison sociale si elle diffère, le domaine officiel, le logo, les profils officiels et les identifiants applicables. Reliez les pages internes à un même identifiant d’entité stable lorsque votre architecture le permet.
4. Aligner les identifiants produit
Comparez Shopify, JSON-LD, Merchant Center et le feed d’avis. Corrigez d’abord GTIN, marque et MPN, puis les SKU, URL et variantes.
5. Corriger les sources contrôlées
Mettez à jour les profils, annuaires ou feeds que vous contrôlez. Ne créez pas de faux profils et ne demandez pas de faux avis pour multiplier les mentions.
6. Signaler l’affirmation fausse
Utilisez le mécanisme de feedback ou de recours de la plateforme avec la requête, la capture, l’affirmation exacte et la source qui la contredit. Pour une atteinte juridique ou réputationnelle, faites évaluer le cas par un professionnel compétent.
7. Demander une nouvelle exploration et refaire le test
Après correction, vérifiez la page, demandez une nouvelle exploration lorsque l’outil le permet, puis rejouez les cinq requêtes avec le même périmètre. Une correction de source ne garantit pas un changement immédiat : cache, index et systèmes tiers ont leurs propres délais.
Ce que cette méthode peut améliorer
Elle peut :
- réduire les contradictions dans les sources contrôlées par la marque ;
- rendre l’entreprise et ses produits plus clairement identifiables ;
- fiabiliser le rattachement des avis dans les feeds qui utilisent les identifiants ;
- produire un dossier de preuve exploitable pour un signalement ;
- détecter une régression après un changement de domaine, de nom ou de catalogue.
Elle ne peut pas :
- garantir le contenu d’une réponse générative ;
- corriger une page tierce sans l’accord de son éditeur ;
- imposer une source à Google, OpenAI ou un autre moteur ;
- transformer schema.org en facteur de classement garanti ;
- prouver la causalité entre une correction et une future citation.
Ce que Verity Score vérifie
Verity Score part de la boutique Shopify et compare les faits disponibles dans la page, le HTML, les données structurées, les avis et les surfaces commerce accessibles. L’audit peut signaler un nom, un identifiant ou une note incohérente entre ces couches et préparer une correction révisable.
Il ne surveille pas toutes les réponses de Google et ne peut pas modifier un AI Overview. Son rôle se situe en amont : réduire les contradictions que la marque contrôle et rendre chaque fait plus facile à rattacher au bon produit.
Vous pouvez lancer l’audit dans l’application Shopify Verity Score. Pour replacer cette méthode dans la stratégie Google complète, consultez aussi notre guide Google AI 2026.
La nouvelle question GEO
Le GEO a longtemps été présenté comme un problème de lisibilité : est-ce que la machine trouve l’information ?
Le cas de Munich montre une seconde question, plus difficile : est-ce que la machine rattache cette information à la bonne entité ?
Une page claire reste nécessaire. Mais à mesure que les réponses combinent davantage de sources, l’identité devient une infrastructure de confiance. Le bon objectif n’est pas de « nourrir l’IA ». C’est de publier assez de cohérence vérifiable pour qu’un nom, un produit, un avis et une politique ne changent pas de propriétaire au moment de la synthèse.